编码转换 · 更新于 2026-11-05 · 10 分钟阅读
Base64、URL 和 Unicode 编码怎么选
同一段中文可以有多种编码形式,选错方式会导致解码失败或乱码。先确认数据来自 URL 参数、JSON 转义还是 Base64,再使用对应工具;不要把编码当成加密。
操作步骤
1. 先识别数据用途,不只看长相
Base64 用可打印字符表示字节;URL 百分号编码用于网址与参数;Unicode 转义把字符写成码点或 UTF-16 单元;十六进制表示字节。字符串看起来像某种编码,不代表一定是这种编码,也可能只是普通文本或二进制文件的编码。
2. 用“你好”核对 UTF-8 Base64
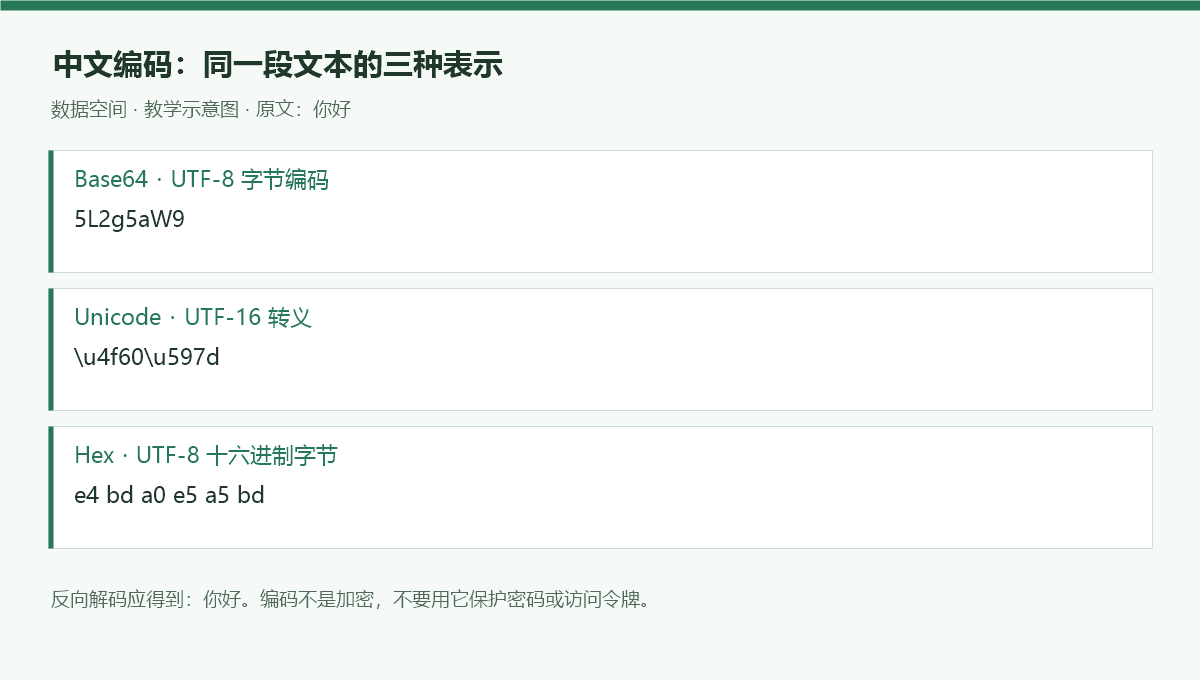
在 Base64 工具选择标准格式并编码“你好”,应得到 5L2g5aW9。反向解码应回到原文。本工具只还原有效 UTF-8 文本;图片、压缩包等二进制内容即使 Base64 合法,也可能被拒绝作为文本解码。Base64URL 使用 - 和 _ 替代 + 和 /,应按来源选择,不能混用字符集。
3. 区分参数值与完整 URL
把“a+b c”作为参数值编码,普通模式得到 a%2Bb%20c,表单模式得到 a%2Bb+c。只有表单模式会把加号解码为空格。完整 URL 模式保留 /、?、& 等分隔符,不适合直接编码单个参数值;不要反复编码已经编码过的整段网址。
4. 查看 Unicode 与字节的差别
“你好”的 UTF-16 转义是 \u4f60\u597d,UTF-8 十六进制字节是 e4 bd a0 e5 a5 bd。某些字符需要两个 UTF-16 单元,也可写成 \u{码点};本站还原时校验代理对,不执行输入的 JavaScript 代码。两种写法描述的层次不同,不要把 Unicode 码点直接当作 UTF-8 字节。
5. 解码失败时回到原始来源排查
检查是否选错标准 Base64/Base64URL,是否少了字符,URL 中的 + 是否被表单处理为空格,百分号后是否有两位十六进制。工具接受合法无填充 Base64,但不会用补齐任意字符的方式猜测原文。解码一次后仍呈现另一层编码,应先确认来源确实做过多次编码。
实例与预期结果
同一段中文,三种可逆表示
用于学习文本表示的区别,可将下方值粘贴到对应工具反向验证。
- Base64:标准格式,编码,再切到解码
- Unicode:UTF-16 转义
- 十六进制:UTF-8 文本字节
示例输入 / 准备
你好
预期结果 / 核对项
Base64: 5L2g5aW9
Unicode: \u4f60\u597d
UTF-8 Hex: e4 bd a0 e5 a5 bd
解码应回到“你好”。如果 Base64 来自图片等二进制文件,这个文本工具不会把它恢复为图片。
URL 参数里的加号和空格
测试单个参数值,不要把整个 URL 当成参数值反复编码。
- 参数值模式
- 分别关闭、开启表单模式
示例输入 / 准备
a+b c
预期结果 / 核对项
普通参数: a%2Bb%20c
表单参数: a%2Bb+c
原文加号必须表示为 %2B。只有表单模式会把未转义的加号作为空格。
遇到问题怎么办
解码后乱码或提示 UTF-8 无效
可能原因:来源可能不是 UTF-8 文本,或选错了编码类型。
处理方法:核对来源字符集、Base64/URL 模式及原文完整性。不要反复解码直到看似可读。
百分号解码失败
可能原因:% 后不是两位十六进制或字节不能构成 UTF-8。
处理方法:回到原始参数,修正来源,不要随意删除百分号。
风险与限制
- 这些编码可逆,不适合保护密码、访问令牌或个人信息。
- 编码工具本地处理,不上传输入;仍不要向截图、剪贴板共享或不可信网址泄露原文。
- 原文字节不是 UTF-8 时,需要先确认实际字符集;本站不会把非法字节替换成乱码后当作成功。
常见问题
为什么 Base64 解码提示不是有效的 UTF-8?
原始内容可能是图片、其他二进制文件,或者使用了 GBK 等字符集。Base64 解码得到字节不代表这些字节必然是 UTF-8 文本;这个文本工具不会自动恢复文件或猜测字符集。
Base64 末尾没有等号是不是一定错误?
不是。某些协议允许省略填充。本站接受合法无填充输入,但仍检查长度、字符集和尾部编码位;不能仅删除或补加等号来修复任意损坏数据。
为什么 URL 解码后加号变成空格?
通常是使用了 application/x-www-form-urlencoded 的规则。普通参数解码保留 +,表单模式将 + 作为空格。原文的加号应编码为 %2B。